AI によるコード改善
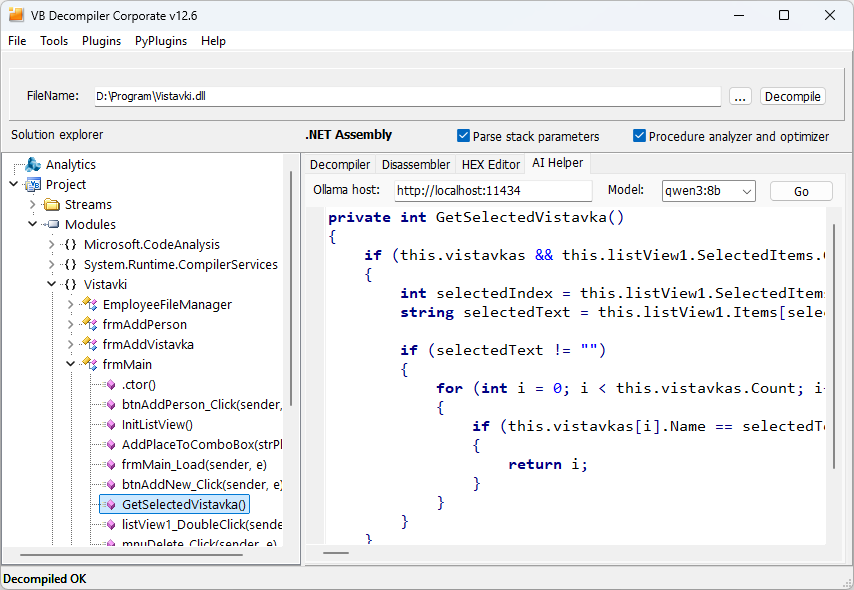
AI 支援 (AI Helper) は、VB Decompiler が既に再構築したコードを処理します。.NET アセンブリからの逆コンパイルされた C# および P-Code または Native Code からの Visual Basic 5.0/6.0 コードをサポートします。Ollama を通じてローカルモデルを使用するか、OpenAI API インテグレーションを通じてサービスに接続できます。
AI は、より明確な制御フロー、変数名、宣言、および式を提案できます。しかし、バイナリから欠落している情報を確実に復元したり、逆コンパイラが誤って解釈した断片を修復したりすることはできません。復元されたソースコードや調査報告書で使用する前に、元の逆コンパイルされたリスト、逆アセンブル、および周辺のプロシージャと比較してください。
プロシージャの処理
- ソリューションエクスプローラー (Solution explorer) で必要なプロシージャを開き、その 逆コンパイラ (Decompiler) リストを確認します。
- AI 支援 に切り替え、以下に説明されているようにプロバイダー、ホスト、およびモデルを設定します。
- モデルセレクターの横にあるアクションボタンで処理を開始します。
- AI 支援 で返されたコードを確認し、逆コンパイラの出力と比較します。
AI 処理は別のスレッドで実行されます。モデルの応答に時間がかかりすぎる場合は キャンセル (Cancel) を使用してください。追加の接続設定を折りたたむことで、コード表示用のスペースを増やすことができます。
Ollama を通じてローカルモデルを使用する
- 公式ダウンロードページ から Ollama をインストールして起動します。
- ターミナルで
ollama pull qwen3:8bを実行して推奨モデルをダウンロードします。 - AI 支援 でローカル LLM/Ollama プロバイダーを選択し、Ollama host にサーバーアドレスを設定します。デフォルトのローカルアドレスは
http://localhost:11434です。 - モデル (Model) でインストールしたモデルを選択して処理を開始します。
qwen3:8b を推奨します。AI 支援 の組み込みプロンプトは、この軽量モデルに合わせて調整されています。より新しいモデルでは、処理結果が改善されないままコードの処理時間が長くなる場合があります。
モデルの選択に制限はありません。選択した Ollama インスタンスにインストールされている任意のモデルを使用できます。未知の応答形式では、応答パーサーがモデル固有のタグやその他の補助テキストを除去できず、表示結果に残す場合があります。
Ollama をローカルで実行するためのハードウェア
ローカル AI 処理は Ollama を実行しているコンピューター上で行われ、逆コンパイルよりも多くのリソースを必要とします。以下は、Q4_K_M 量子化の重みと標準の f16 コンテキストキャッシュを使用する qwen3:8b で、同時に 1 件のリクエストを処理する場合の実用的な構成の目安です。コンテキストはトークン単位で、4K は 4096 トークン、128K は 131072 トークンです。この容量には指示、ソースコード、生成される回答が含まれます。
| 項目 | 実用上の最小構成:4K | 推奨構成:128K |
|---|---|---|
| OS | 64 ビット版 Windows 10(22H2)または Windows 11 | 64 ビット版 Windows 10(22H2)または Windows 11 |
| CPU | AVX2 対応の現行 x64 CPU、物理コア 4 個以上 | AVX2 対応の現行 x64 CPU、物理コア 8 個以上 |
| システムメモリ(RAM) | 16 GB | 64 GB |
| グラフィックスカード | Ollama 対応 GPU、専用 VRAM 8 GB 以上 | Ollama 対応 GPU、専用 VRAM 32 GB 以上 |
| ストレージ | Ollama とこのモデル用に 20 GB 以上の空き容量がある SSD | Ollama とこのモデル用に 20 GB 以上の空き容量がある SSD |
Ollama 設定のスライダーでコンテキスト長を選択します。4K に適した 8 GB のカードでは、上記の 128K 構成には不足します。モデルのダウンロードサイズは約 5.2 GB ですが、必要なメモリの総量はこれより大きくなります。128K では f16 コンテキストキャッシュだけで約 18 GiB を使用し、さらにモデルの重みと作業用バッファーが必要です。Windows や他のアプリケーション用のメモリも確保してください。
十分な RAM があれば Ollama は CPU でも処理できますが、コードの処理が非常に遅くなる場合があります。Pentium M 搭載機や同程度の古いコンピューターは、qwen3:8b のローカル実行には適しません。旧世代の Intel HD Graphics の共有メモリは、上記の専用 VRAM の代わりにはなりません。これらの要件は Ollama を実行するコンピューターに適用されます。リモートサーバーや外部 API サービスでは、そのサービス側のハードウェアを使用します。
短いプロシージャでは 4K から始めてください。コンテキストを大きくすると、メモリ使用量と長い入力の処理時間が増加します。処理が遅すぎる場合は中止し、コンテキストを小さくして、ollama ps で GPU の使用状況を確認してください。実際のメモリ使用量は Ollama のバージョン、バックエンド、他の実行中の処理によって異なります。
OpenAI API インテグレーションを使用する
提供元 (Provider) を OpenAI API に設定します。ホスト (Host)、APIキー (API key)、および モデル を意図したサービスに合わせて設定します。有効な API キーと、そのキーで利用可能なモデル識別子を入力します。API キーをスクリーンショットや共有された分析資料から除外してください。
AI 支援 は OpenAI API プロバイダーを通じて DeepSeek もサポートしています。対応するフィールドに DeepSeek のホスト、API キー、およびモデル識別子を記入します。以下のスクリーンショットがこの設定を示しています。

コードが処理される場所
AI 支援 は、現在の逆コンパイルされたコードを構成されたサービスに送信します。ローカル専用ワークフローの場合、ローカルで実行されている Ollama サーバーとローカルで実行されたモデルを使用します。別のマシン上の Ollama ホスト、Ollama クラウドモデル、または外部 API サービスは、コードを分析ワークステーションの外へ転送できます。
機密ソースの復元やセキュリティ調査の場合、組織のデータ処理要件に応じてエンドポイントを選択してください。Ollama や localhost URL の存在だけでオフライン動作を推測しないでください。
トラブルシューティング
- ローカルモデルが欠落している場合は、ホストフィールドで指定された Ollama インスタンスにインストールされていることを確認します。
- 応答がない場合は、選択したサービスが実行中であり到達可能であることを確認し、エンドポイント、認証情報、およびモデル識別子が同じプロバイダーに対応していることを確認します。
- 処理が遅すぎる場合はキャンセルします。別のローカルモデルを使用する場合、推奨される
qwen3:8bモデルを試してください。 - 未知のモデルが応答にタグやその他の補助テキストを残す場合は、
qwen3:8bを試すか、結果を確認しながらそのテキストを手動で削除してください。 - 結果が条件、呼び出し、定数、または型を予期せず変更した場合は、低レベルリストに対して確認してください。読みやすさだけでは、元のコードと同等の動作であることは確認できません。
Ollama および外部モデルプロバイダーはサードパーティ製製品です。その可用性、モデルの動作、およびサービスポリシーは VB Decompiler に依存しません。